 Illustration
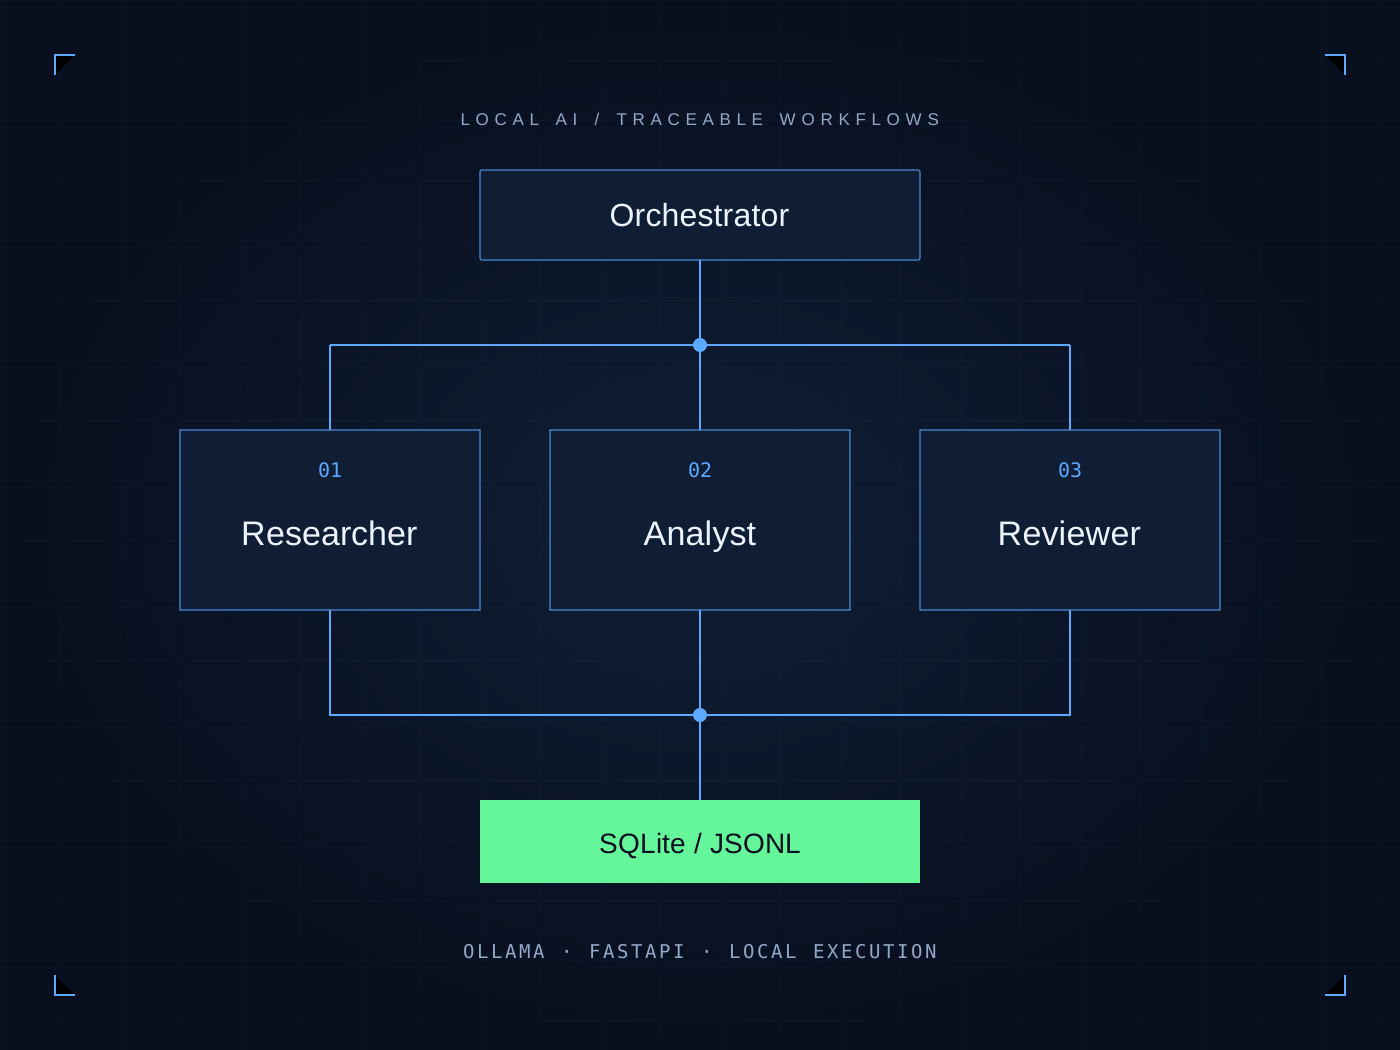
Une IA qui laisse une trace.
Un système local multi-agents qui intègre les preuves, la revue et les traces d’exécution au traitement des documents.
Découvrir le projetIA / Apprentissage par renforcement
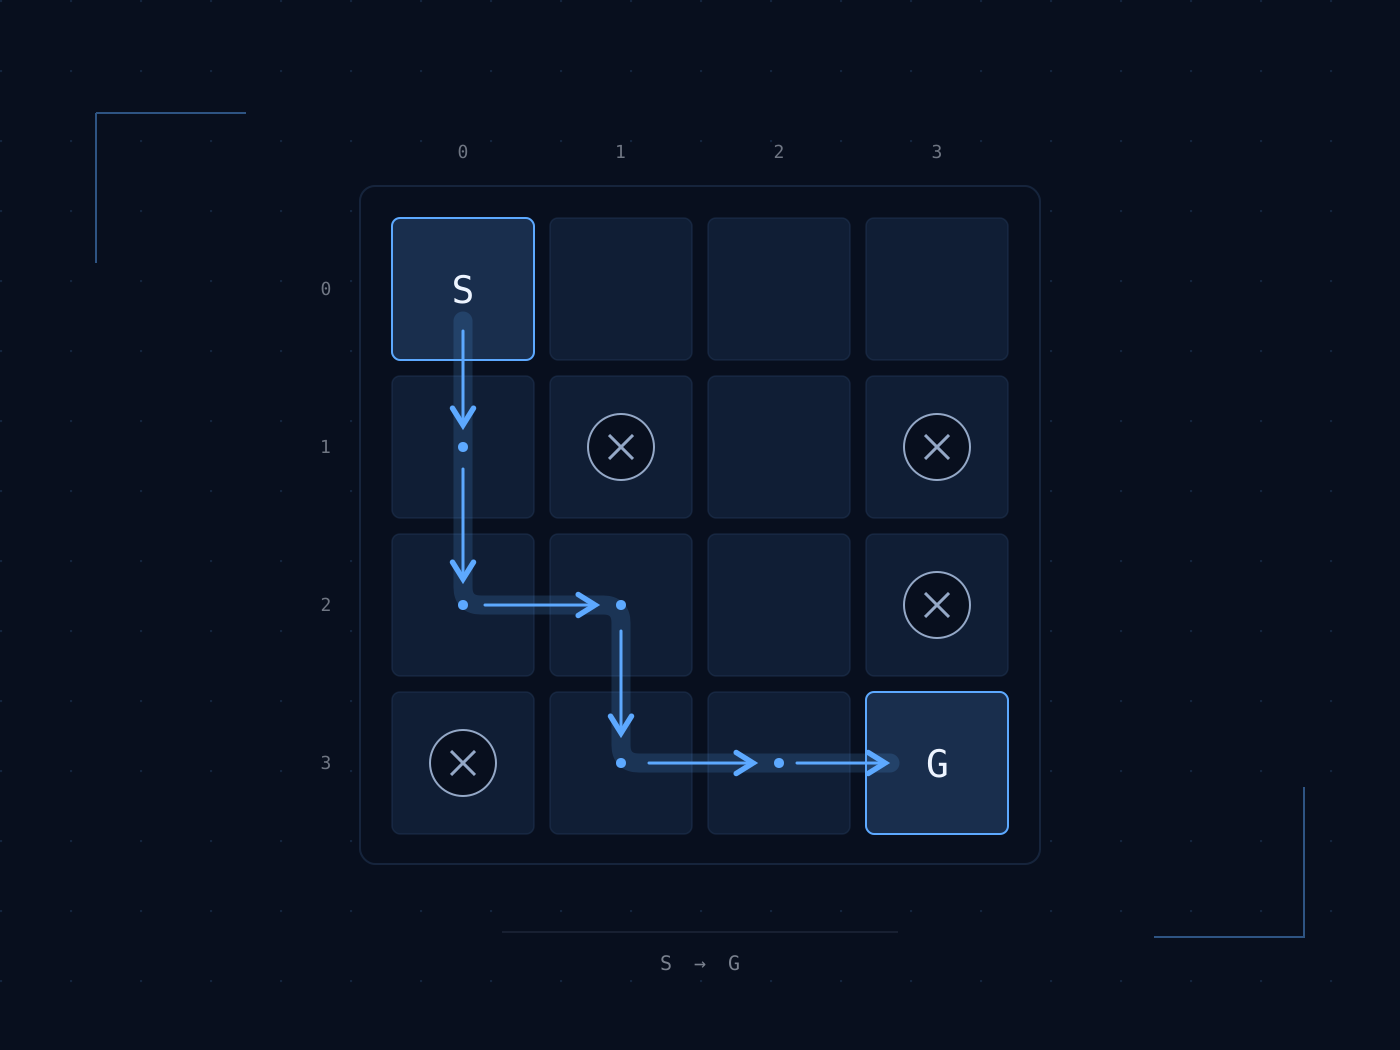
Comparer une table Q et un réseau Q profond dans l’environnement FrozenLake.
01 / Le défi
Comprendre comment l’exploration, les récompenses et la représentation des valeurs influencent le comportement appris.
Une exploration pédagogique de la manière dont un agent apprend à partir de récompenses. Deux approches traitent la même tâche sur une grille : le Q-learning tabulaire mémorise directement les valeurs état/action, tandis qu’un réseau de neurones PyTorch les approxime.
02 / La démarche
Comparer le Q-learning tabulaire à un réseau Q profond dans le même environnement.
Adapter les récompenses et faire évoluer le taux d’exploration ; utiliser une mémoire de rejeu et un réseau cible pour le DQN.
Suivre les récompenses et l’exploration pendant l’entraînement, puis visualiser les résultats d’évaluation.
03 / Résultats
04 / Périmètre & prochaines étapes
La référence de départ provient de johnnycode8/gym_solutions. Les autres scripts adaptent ce travail avec des récompenses, une validation et des visualisations modifiées ; l’attribution est conservée dans le dépôt.
Poursuivre l’exploration
IllustrationUn système local multi-agents qui intègre les preuves, la revue et les traces d’exécution au traitement des documents.
Découvrir le projet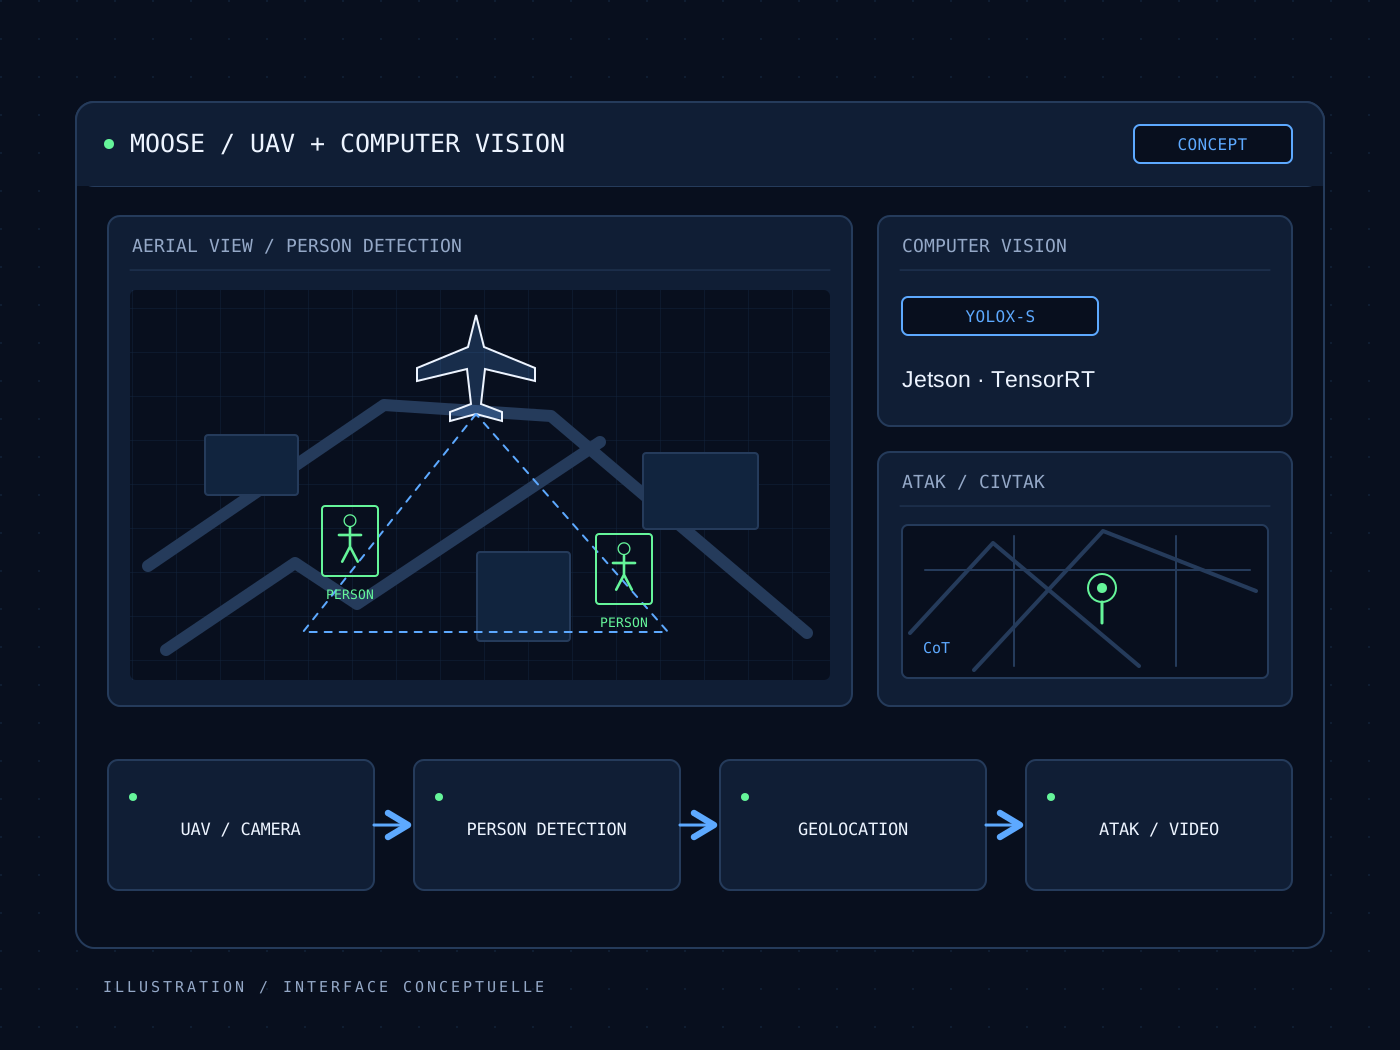 Illustration
Détection aérienne de personnes. La vision par ordinateur sur un UAV à voilure fixe, reliée à ATAK.
Découvrir le projet